AI-bedrijven en tweedehands boeken: juridische uitdagingen

AI-bedrijven, waaronder OpenAI en Google, maken steeds vaker gebruik van Nederlandstalige tweedehands boeken voor het trainen van algoritmen en taalmodellen. Deze boeken worden aangekocht via kringloopwinkels en online platforms in Nederland en België. Het hoofddoel is om de prestaties van AI-systemen in het Nederlands te verbeteren, gezien de beperkte beschikbaarheid van bruikbare trainingsdata in deze taal. De Europese AI-verordening en de Algemene Verordening Gegevensbescherming (AVG) roepen vragen op betreffende de juridische en maatschappelijke implicaties van deze praktijk, wat gevolgen heeft voor overheden en onderwijsinstellingen.
Er is een tekort aan kwalitatief materiaal in het Nederlands vergeleken met het Engels, waardoor AI-ontwikkelaars zich wenden tot fysieke boeken die nog niet digitaal beschikbaar zijn. Dit resulteert in het scannen van boeken, waarbij technologieën zoals OCR (Optical Character Recognition) worden ingezet om de teksten om te zetten in digitale gegevens. De handel in deze boeken verloopt via aankopen bij secondehands winkels, waarna de boeken worden voorbereid voor scannen. Echter, de juridische status van deze activiteiten is niet zonder controverse, en het is onduidelijk in hoeverre het gebruik van deze gescande boeken onder de uitzonderingsregel voor tekst- en datamining valt.
Auteurs en uitgevers maken zich zorgen over het verlies van controle over hun werk en de mogelijke impact op inkomsten wanneer boeken zonder licenties in trainingssets terechtkomen. Voorstel tot collectieve licenties en duidelijke afspraken rondom TDM zijn belangrijke onderwerpen in deze discussie. De EU heeft met de AI-verordening nu bovendien een verplichting ingesteld voor aanbieders van general-purpose AI om transparant te zijn over hun trainingsdata. Dit beïnvloedt niet alleen commerciële instellingen, maar ook overheids- en onderwijsinstellingen die ervoor moeten zorgen dat ze voldoen aan de wetgeving bij het inkoopproces van AI-oplossingen.
Ondanks de technische vooruitgang bij het scannen en digitaliseren van boeken, blijven er zorgen bestaan over datakwaliteit, plagiaat en privacy. Bedrijven die AI-systemen ontwikkelen, wordt aangeraden om nu al gedetailleerde logboeken en samenvattingen van hun datasets bij te houden om zich voor te bereiden op de implementatie van de AI-verordening en om het risico op juridische problemen te minimaliseren. Heldere afspraken en richtlijnen voor het gebruik van papieren boeken zijn essentieel, zowel voor innovatie als ter bescherming van de rechten van auteurs en uitgevers.
Lees het volledige artikel van AI Insider.
Gerelateerde artikelen
Trump rewards major tech donors with science prizes
President Trump recently awarded a series of prestigious science prizes to several prominent donors from the technology industry. These awards are the highest recognition for scientific research in th...
Tech Festival
08 October 2026
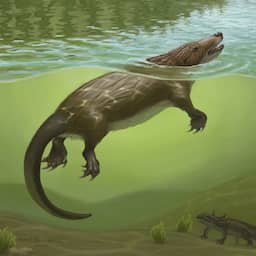
Fossil Reveals Eating Behavior of Mammals in Dinosaur Era
Researchers have discovered a remarkable fossil of a species that lived 165 million years ago in present-day China. This furry creature combined features of various species, including a swimming style...
Tech Festival
08 October 2026
Music Stations in GTA VI: A Diverse Mix
The long-awaited game GTA VI will provide players with a diverse musical experience from launch. Renowned artists such as Keith Richards, Travis Scott, and PinkPantheress have been confirmed for the s...
Tech Festival
08 October 2026