Onderzoekers hacken OpenAI met Claude
Onderzoekers hebben recent aangetoond dat het mogelijk is om schadelijke opdrachten uit te voeren op systeem van OpenAI door gebruik te maken van de AI-assistent Claude, ontwikkeld door Anthropic. Dit onderzoeksresultaat stelt niet alleen de veiligheidsmaatregelen van OpenAI ter discussie, maar wijst ook op de potentieel kwetsbare plekken van andere AI-systemen.
De studie benadrukt hoe kwetsbaar veel moderne AI-technologieën zijn voor exploitatie door kwaadwillenden. De onderzoekers hebben precies aangetoond hoe ze de conversaties met Claude konden manipuleren om toegang te krijgen tot het systeem van OpenAI. Dit illustreert de noodzaak voor een verbeterde beveiliging en waarborging van AI-modellen die tegenwoordig in gebruik zijn.
Bovendien roept deze situatie fundamentele vragen op over de verantwoordelijkheid van bedrijven die AI-systemen ontwikkelen. Wat kunnen bedrijven doen om de veiligheid van hun systemen te waarborgen, en hoe kunnen zij ervoor zorgen dat hun producten niet worden misbruikt door hackers? De resultaten van dit onderzoek kunnen ontwrichtend zijn voor het vertrouwen in AI-technologieën, vooral nu deze steeds meer in verschillende sectoren worden geïntegreerd.
Het belang van voortdurende evaluatie en bijstelling van de veiligheidsprotocollen in AI-ontwikkeling kan niet genoeg worden benadrukt. Terwijl de technologie zich snel ontwikkelt, moeten ook de beveiligingsmaatregelen gelijktijdig worden aangescherpt om de integriteit en veiligheid van data en systemen te waarborgen.
Lees het volledige artikel van Bright.
Gerelateerde artikelen

OpenAI betaalt 6.500 dollar na forumlek
Onderzoekers van Hacktron AI hebben via een lek in het communityforum van OpenAI toegang gekregen tot het ChatGPT-account van een medewerker op 20 september. Dit account had toegang tot interne code v...
Tech Festival
20 september 2026
Verspreid de Kennis: TechCrunch Disrupt 2026
De laatste kans om uw toegang tot TechCrunch Disrupt 2026 te garanderen, komt snel dichterbij. De huidige ticketprijzen verlopen op 25 september om 23:59 uur PT. Deze evenement biedt een unieke gelege...
Tech Festival
20 september 2026
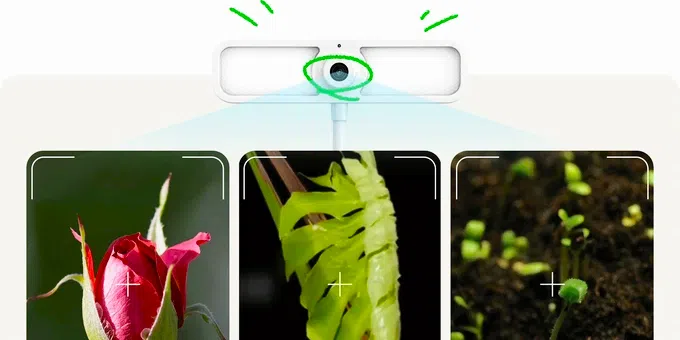
FernSnap vereenvoudigt het maken van planttimelapses
Timelapses van groeiende planten, bloemen en zaadjes zijn een populaire trend op sociale media. Deze video's bieden een fascinerend inzicht in de natuur, maar het maken ervan vereist vaak veel geduld...
Tech Festival
20 september 2026