Efficiënte Geheugenutilisatie in AI dankzij Volledige Stack Codesign
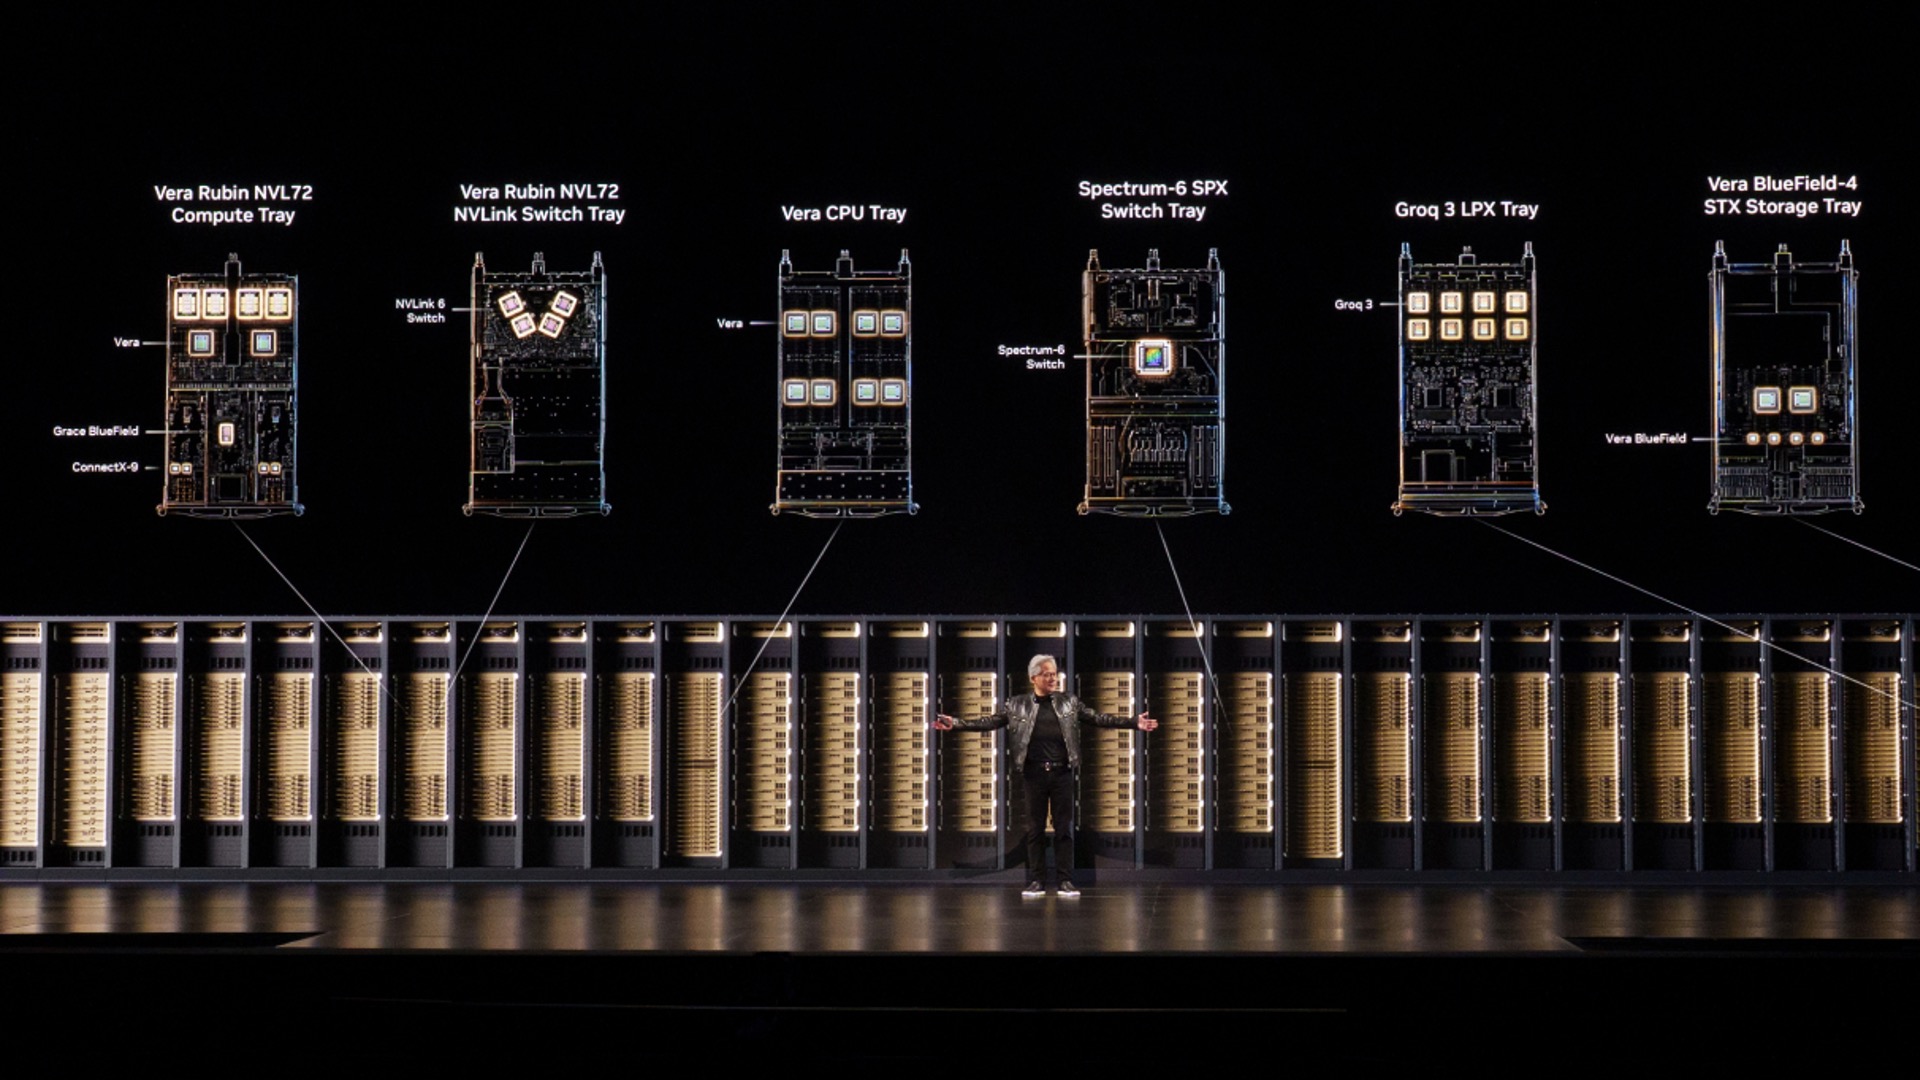
De groei van grotere AI-modellen en agentische toepassingen zorgt voor een toenemende druk op het GPU-geheugen. Tegelijkertijd zijn deze geheugencomponenten beperkt beschikbaar en stijgen de prijzen. NVIDIA reageert op deze uitdagingen door nauwe samenwerking met geheugenpartners en snel nieuwe technologieën, zoals HBM3e en HBM4, te adopteren. Het bedrijf implementeert echter geen simpele oplossing door meer geheugen op de GPU's te plaatsen, maar focust op een volledige stack codesign. Dit houdt in dat NVIDIA GPU's, CPU's, netwerken, opslag en software samen ontwerpt om zo de efficiëntie van het geheugen op elk niveau te verbeteren.
Het gebruik van geheugen in een AI-fabriek is gebaseerd op een hiërarchie van geheugen en opslag, waarbij hyperbandbreedte geheugen (HBM) de snelste en duurste laag vormt, gevolgd door CPU-geheugen en lokale SSD's. De effectiviteit van elke byte geheugen hangt sterk af van hoe goed deze lagen worden benut. NVIDIA's aanpak concentreert zich op het optimaliseren van de opslagvereisten door data strategisch te plaatsen en efficiënte technieken toe te passen die de behoefte aan geheugen verminderen.
Met ontwikkelingen zoals de NVFP4-format en samenwerking met verschillende partners gericht op context-geheugenbeheer, vermindert NVIDIA de belasting op HBM door modelgewichten en KV-cache te verkleinen. Dit biedt meer ruimte voor actieve opslag van context data en maakt het mogelijk om deze efficiënt te gebruiken via de Dynamo-inference software. Dit systeem beheert de KV-cache als een gezamenlijk hulpmiddel dat de samenwerking tussen GPU- en CPU-geheugen bevordert.
De resultaten zijn opmerkelijk, want ondanks een beperkte groei in HBM-capaciteit per GPU, blijkt dat de doorvoer per dollar op verschillende platformen aanzienlijk toeneemt. Door de combinatie van het elite geheugenbeheer en een slimme structuur, kunnen AI-fabrieken meer nuttige gegevens binnen hun vermogensbudget leveren. NVIDIA's volledige stack codesign resulteert niet alleen in een hogere doorvoer, maar verlaagt ook de kosten per token, wat cruciaal is voor de toekomstige ontwikkeling van AI-toepassingen.
Lees het volledige artikel van Nvidia.
Gerelateerde artikelen

Axiom Math en de toekomst van wiskundige verificatie
Axiom Math, een startup die zich richt op het waarborgen van de integriteit binnen de wiskunde, reageert op de toenemende invloed van ongereguleerde kunstmatige intelligentie (AI) die momenteel wiskun...
Tech Festival
05 november 2026
Chris Alexiuk: De Tovernaar van Open AI-modellen
Chris Alexiuk, senior product research engineer bij NVIDIA, is een fervent voorstander van open source AI. Hij benadrukt dat transparantie essentieel is voor de ontwikkeling van goede AI en dat open s...
Tech Festival
05 november 2026
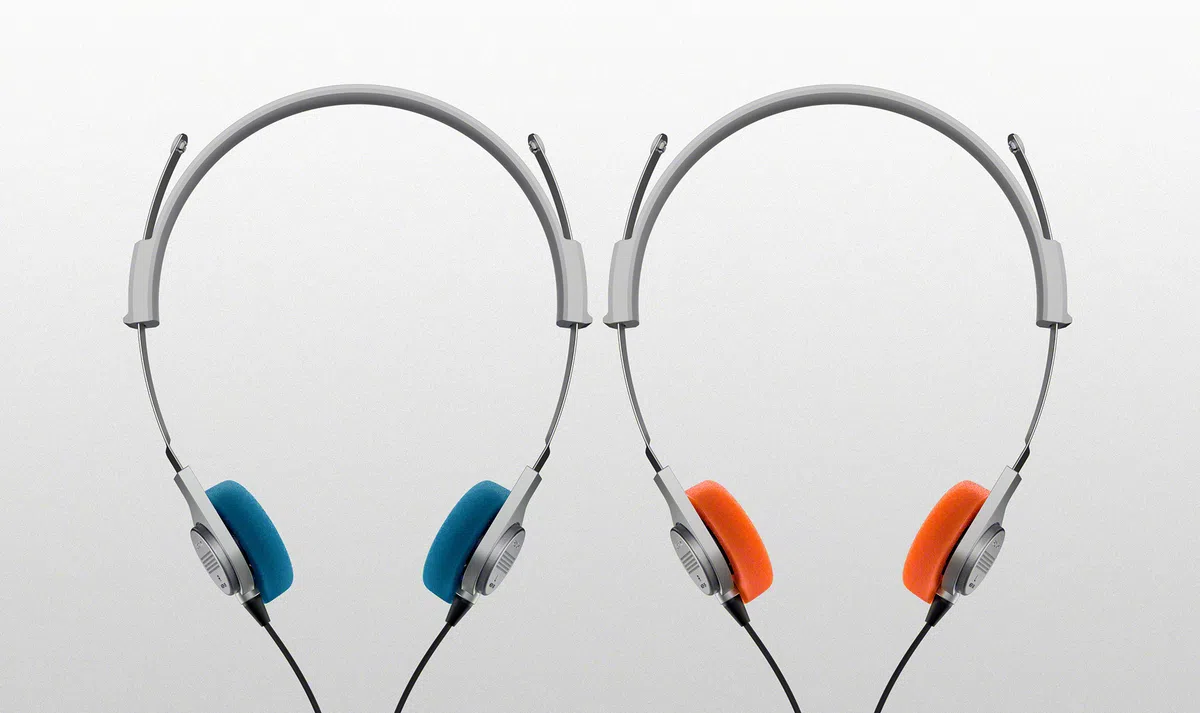
Sony lanceert moderne variant van klassieke Walkman-koptelefoon
Sony heeft onlangs een moderne variant geïntroduceerd van zijn iconische MDR-3-koptelefoon, die oorspronkelijk in 1979 werd uitgebracht samen met de eerste Walkman. De nieuwe versie, de MDR-3R, combin...
Tech Festival
05 november 2026