Compact 32MB Speechmodel van Underdog

Underdog heeft recentelijk een nieuw spraakmodel gepresenteerd dat opmerkelijk is vanwege zijn bescheiden formaat van slechts 32MB. Dit model is in staat om niet alleen spraak te genereren, maar ook muziek. Dit opent nieuwe mogelijkheden voor toepassingen in spraakgestuurde technologie en creatieve projecties, zonder dat er grote hoeveelheden opslagruimte voor nodig zijn.
De focus van Underdog ligt op het efficiënt ontwikkelen van modellen die tegelijkertijd krachtige prestaties kunnen leveren. De impressie die het model achterlaat, getuigt van de technologische vooruitgang op het gebied van kunstmatige intelligentie, zelfs met beperkte middelen. In een tijd waarin veel AI-modellen enorme hoeveelheden data vergen, biedt Underdogs innovatie een verfrissende benadering die vooral aantrekkelijk is voor organisaties met een kleinere infrastructuur.
Met de mogelijkheid om spraak en muziek te combineren, kan het model interessante toepassingen vinden in verschillende sectoren, zoals entertainment, onderwijs en de gezondheidszorg. De kleine bestandsgrootte maakt het toegankelijker voor een breder scala aan ontwikkelaars en bedrijven die willen experimenteren met spraak- en muziektechnologieën, zonder dat ze zich zorgen hoeven te maken over hoge kosten of complexe implementatie.
Underdog's presentatie biedt een indicatie van de toekomst van AI-technologieën: steeds meer geavanceerd en tegelijk steeds toegankelijker voor een bredere gebruikersbasis. Dit kan uiteindelijk leiden tot meer innovatie en creativiteit in de sector, omdat meer professionals toegang krijgen tot krachtige tools die hun werk kunnen verbeteren.
Lees het volledige artikel van Techcrunch.
Gerelateerde artikelen
Anthropic versnelt AI-ontwikkeling door zelflerende systemen
AI-bedrijf Anthropic heeft recentelijk aanzienlijke vooruitgang geboekt in de ontwikkeling van kunstmatige intelligentie, waarbij het nu in één jaar tijd evenveel vooruitgang boekt als voorheen in twe...
Tech Festival
06 november 2026
Amazon introduceert tekstfunctie voor Alexa
Amazon heeft aangekondigd dat het binnenkort mogelijk wordt om tekstberichten naar Alexa te sturen om hulp te krijgen bij winkelen. Deze functie zal in de komende weken worden uitgerold naar miljoenen...
Tech Festival
06 november 2026
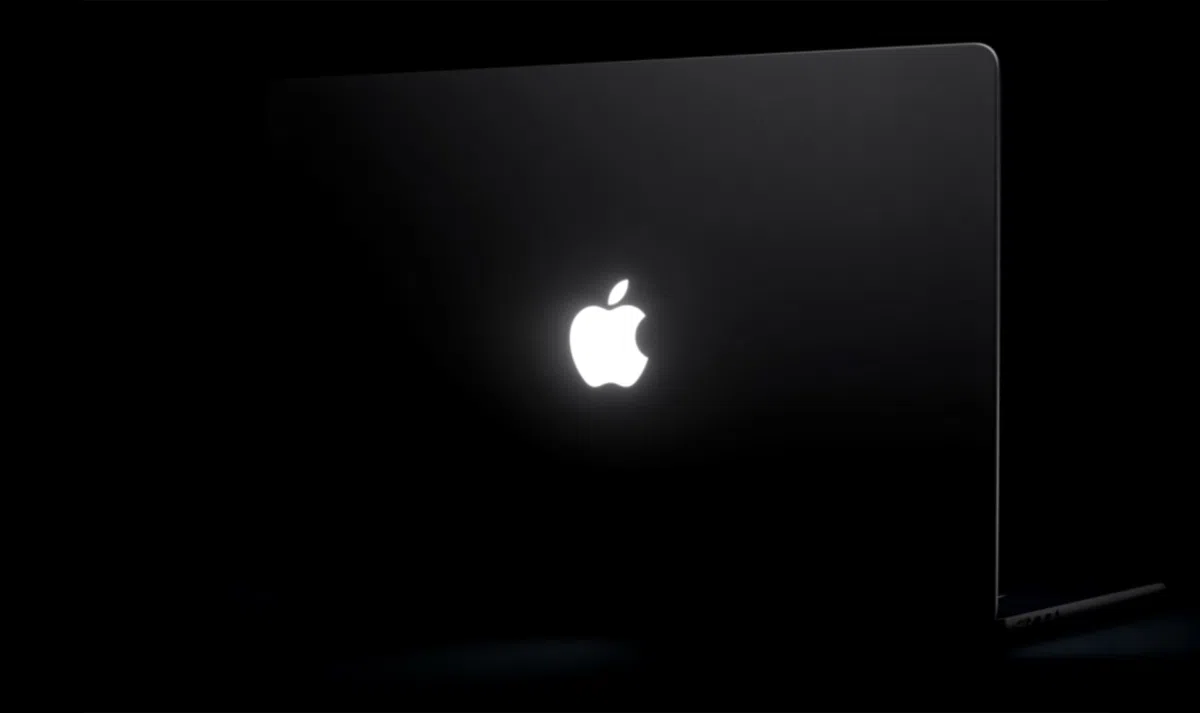
Terugkeer van het lichtgevende logo in MacBook Pro
Apple heeft recentelijk het lichtgevende logo teruggebracht op de nieuwe MacBook Pro, voorzien van het PROLED XDR-scherm. Na een afwezigheid van tien jaar biedt deze herintroductie tech-liefhebbers ie...
Tech Festival
06 november 2026